引言:
在平常vibe coding开发或者听群里一些人谈论技术时,我们经常会看到如auth,构造请求这样的说法,大多数人或多或少都见过auth,token,sign,Authorization这些字段,却没有想过这些用于身份认证的字段到底是做什么的。
其实身份认证的核心从头到底只有一个:服务器凭什么相信这个请求?
一.服务器为什么不能直接相信请求
1.1 HTTP请求天然不可信
HTTP请求本质上是一段可以被客户端构造的数据,客户端随便说自己要做什么,在哪里,有什么权限,并不代表服务器就要相信这些,因为请求可能被伪造,造成越权等漏洞,还有篡改,旧请求也可能被重放,导致邮箱轰炸等问题。
由此引出了三个问题:
- 这个请求是谁发的
- 这个请求有没有被改过
- 这个用户到底有没有权限做这个事
一般的http请求类似于:
POST /api/checkin
Host: example.com
Content-Type: application/json

{
  "latitude": 29.56,
  "longitude": 106.55
}
那么问题是:
- 服务器凭什么相信这个请求是你发的?
- 凭什么相信里面的定位没被改?
- 凭什么相信这不是别人复制你以前的请求重放了一遍?
二.什么是Auth
2.1 什么是auth
这里区分三个词
Authentication:认证,证明你是谁
Authorization:授权,判断你能做什么
Access Control:访问控制,系统具体执行拦截或放行
Auth一般指的是authentication认证的缩写,就是在普通业务数据的外面加了一层的身份证明
2.2 最常见的Auth形态:token,session,cookie
2.2.1 token
一般在登录网站成功后,服务器会给你一个token,token可以理解成一张临时的门票,也可以说是一种身份凭证,访问接口时不需要每次都输入账号密码,而是带上token
像很多agent skills也是通过token或者cookie来操纵用户的应用的
POST /api/profile
Authorization: Bearer <access_token>
所以token泄露是比较危险的
2.2.2 cookie
token是身份凭证,而cookie是存放和携带token的一种方式,当然token完全可以不放在cookie里,最常见的是由前端代码直接放在请求头里
2.2.3 session
session是服务器端的会话状态,会话就是服务器为某个用户一段时间连续访问过程建立的临时身份档案,在登录成功后,服务器在自己数据库或者缓存里会创建一条会话记录
session_id = abc123
user_id = 10086
expires_at = ...
然后服务器一般会把session_id放到浏览器Cookie里
Cookie: session_id=abc123以后浏览器的每次请求都会自动带上Cookie,服务器通过session_id查到你是谁
所以为什么cookie可以免登录?
本质上不是cookie本身让你登录,而是因为Cookie里面保存了一个凭证,如session_id,服务器可以用来找到cookie
三.timestamp和nonce是干什么的
光有签名的话其实还不够,因为别人可能抓到一条合法请求,然后原封不动再发一次,甚至直接用脚本一直发
所以在请求里面一般会加上
timestamp:时间戳
nonce:一次性随机数
时间戳表示某个请求生成的时间,作用是让服务器判断这个请求是不是太旧
比如后端规定只接受5分钟内生成的请求,服务器收到请求后,会比较
当前服务器时间-请求里的timestamp <= 5min
如果超过5分钟就拒绝
而nonce是只使用一次的 随机数,如果同一个nonce再次出现,服务器就会拒绝
四.什么是JWT
JWT是一种结构化token,通常由Header,payload,signature三部分组成,所以平常见到的形式一般为是xxx.xxx.xxxx,它的重点不是加密,而是签名
JWT全称是JSON Web Token,可以理解为一种带有签名,结构化,可以被服务器验证的token
JWT的长相示例:
eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9
.
eyJ1c2VySWQiOjEwMDg2LCJyb2xlIjoic3R1ZGVudCIsImV4cCI6MTcxNTAwMDAwMH0
.
abc123signature
其实也就是Header.Payload.Signature,即头部.载荷.签名
4.1 Header,说明token是怎么签的
header通常长这样:
{
  "alg": "HS256",
  "typ": "JWT"
}
alg是签名算法,如HS256,RS256
typ是类型,这里是JWT,这里就是在高速服务器这个JWT是用什么算法生成签名的
4.2 Payload:真正装身份信息的地方
Payload也叫Claims里面放的是声明信息
如:
{
  "userId": 10086,
  "username": "sunmingrui",
  "role": "student",
  "exp": 1715000000
}
不过需要注意的是payload不是安全隐藏区,通常只是Base64url编码,别人解码是可以看得到的
所以JWT里面不要放密码,身份证好,手机号,秘钥等敏感信息
4.3 Signature:JWT的灵魂
Signature即签名
它的作用不是加密,而是防止Header和payload被篡改
大致是如下生成的
signature = HMACSHA256(
  base64UrlEncode(header) + "." + base64UrlEncode(payload),
  secret
)
所以JWT的流程是服务器拿到Header + payload +秘钥,算出一个签名,然后像乐高积木一样拼接成
Header.Payload.Signature
客户端拿到JWT后,每次请求都会带上
Authorization: Bearer <jwt>在服务器收到JWT后,会重新计算一遍,接着验证signature是否一致
所以JWT本质不是加密,而是签名,header和payload都是base64url编码,随随便便就能破解出来
主要是别人虽然可以看到内容,但不能进行修改
五.OAuth 2.0与OIDC,第三方登录背后的授权与认证
先引入一个场景,比如说登录chatgpt,一般会选择使用Google登录
chatgpt官网不会问你你的谷歌账号的用户名和密码是多少,而是调整到谷歌的界面登录并进行授权,GPT官网根据Google返回的信息创建或登录本地账号
所以这就是第三方登录背后的基本思想:用户不把密码交给第三方应用,而是让可信的身份提供方签发凭证
5.1 OAuth2.0
OAuth2.0解决的用户授权第三方平台访问自己某个平台的部分资源,比如你用notion去连接你的谷歌Drive,notion想做的是读取你的Google Drive文件,创建新文档之类的事情。
OAuth2.0的做法是:
你去 Google 官方页面确认授权
↓
Google 给这个应用一个 access_token
↓
这个应用拿 access_token 去访问允许范围内的资源
关键是:OAuth2.0给第三方应用的是access_token,而不是用户密码
这里的access_token可以理解为:第三方应用访问用户资源的临时通行证,一般是有权限范围,也就是scope
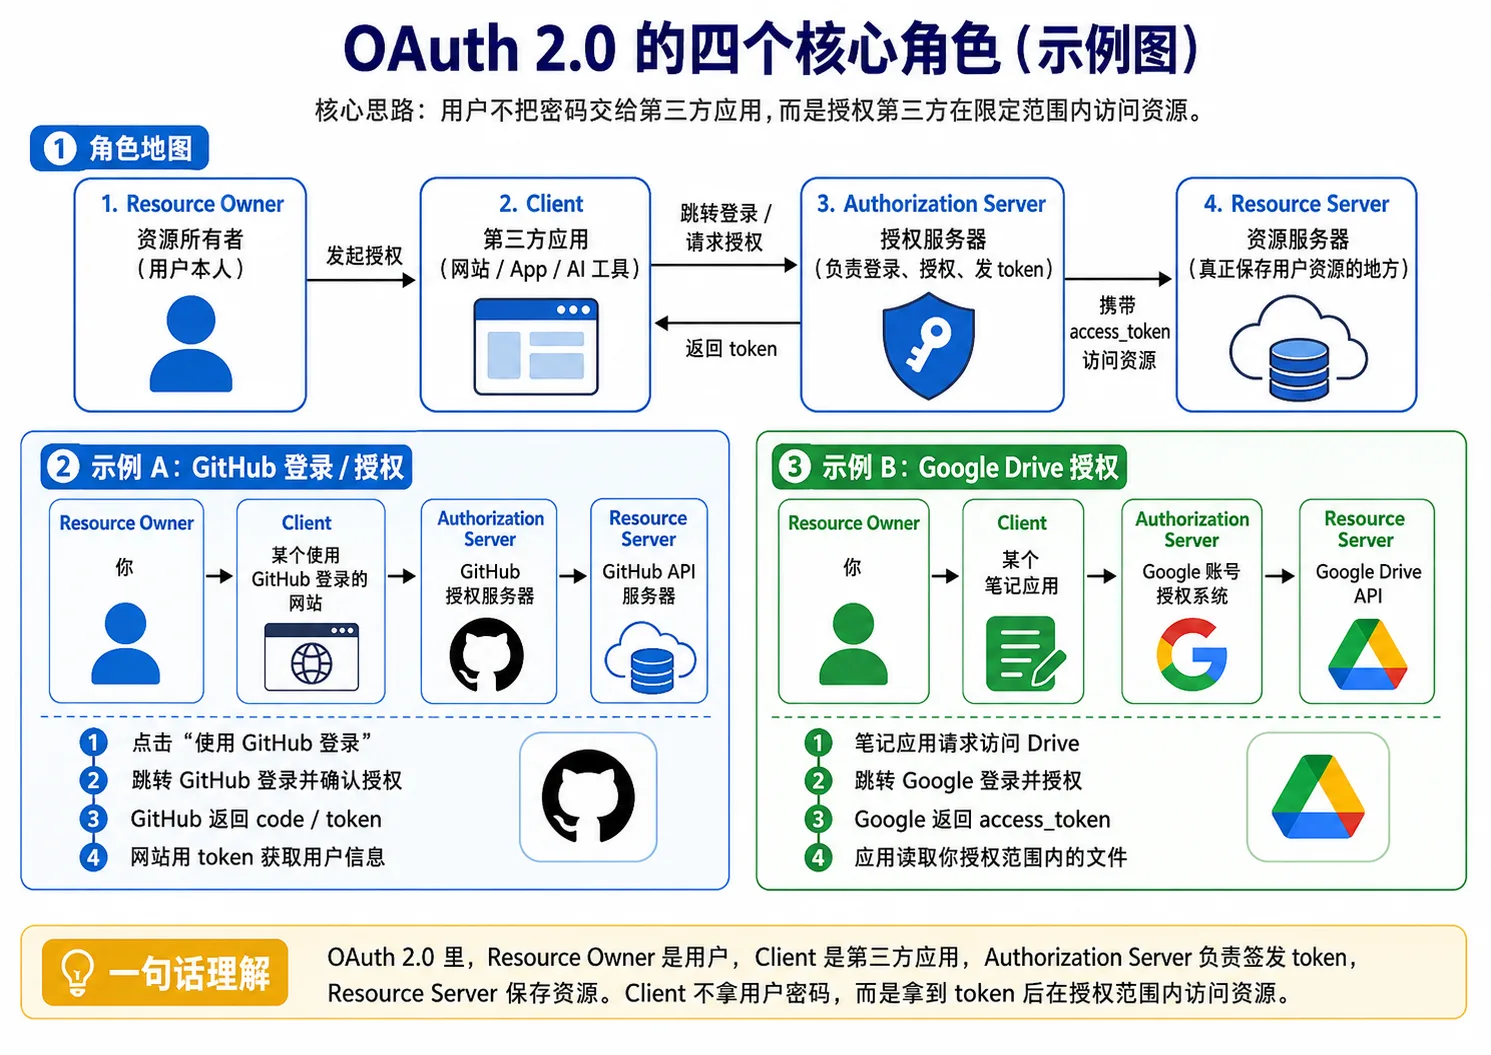
OAuth2.0的典型流程:
用户点击“使用 GitHub 登录”
↓
网站把用户跳转到 GitHub 授权页面
↓
用户在 GitHub 页面登录并确认授权
↓
GitHub 带着 authorization code 跳回网站
↓
网站后端拿 authorization code 去 GitHub 换 access_token
↓
网站用 access_token 请求 GitHub API
↓
GitHub 返回用户信息
↓
网站根据 GitHub 用户信息完成登录或注册
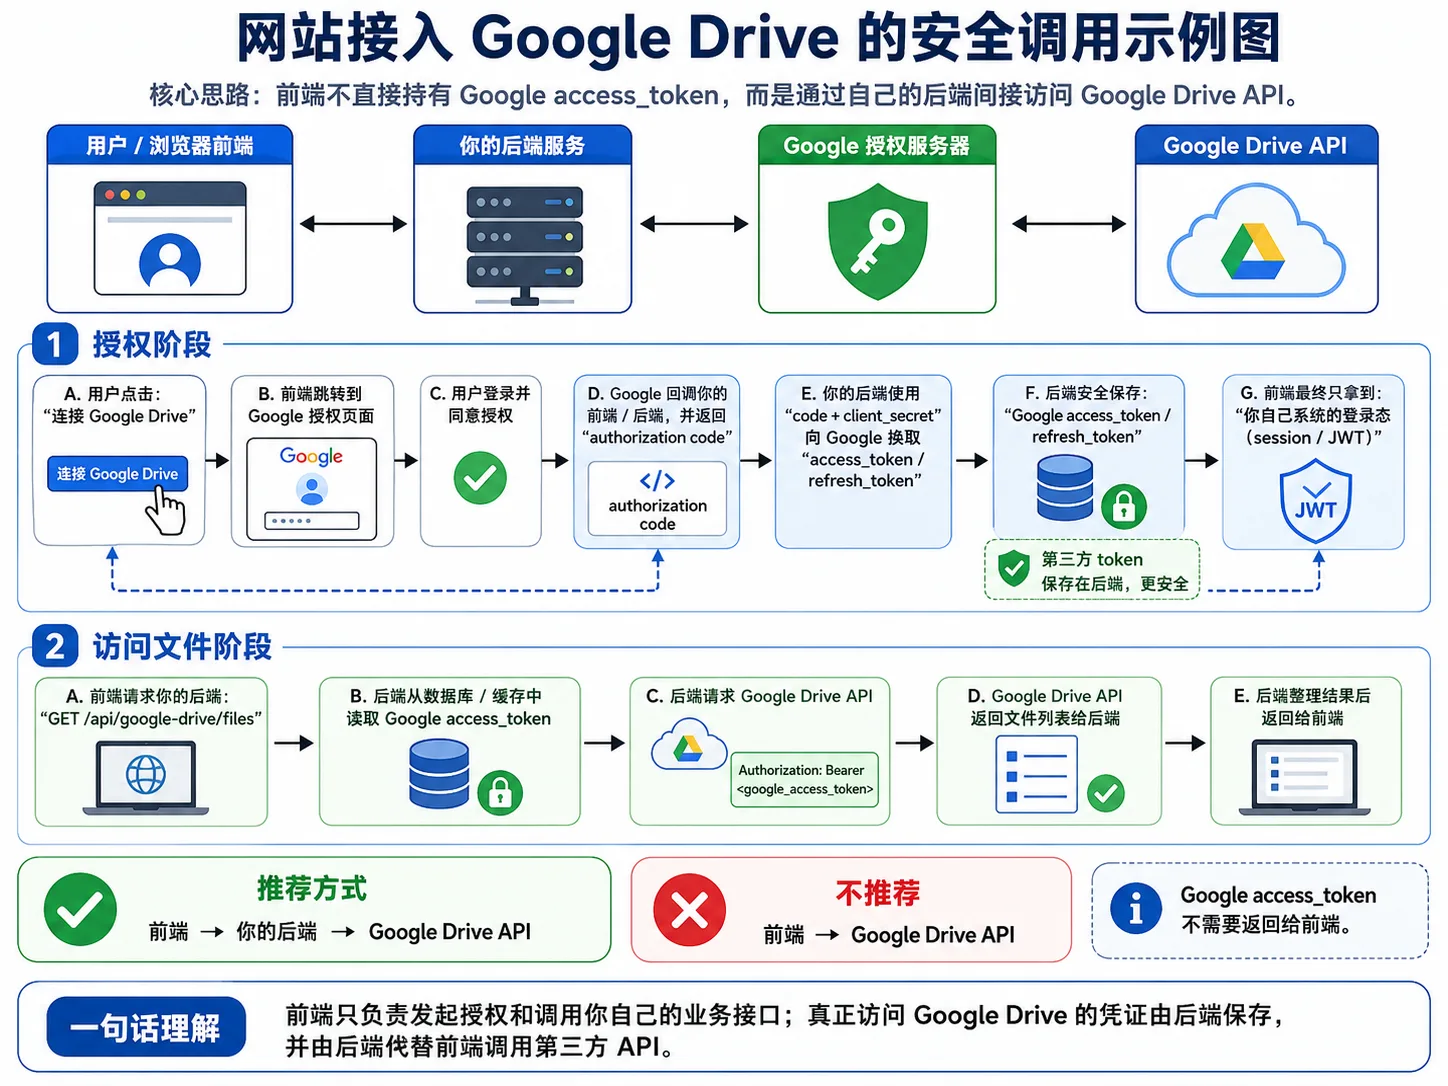
这里其实有个中间产物:authorization code
它相当于是一个临时的授权码,网站后端拿这个code去换取真正的access_token
至于为什么不直接返回access token呢,有如下几个问题
- url可能被浏览器历史,日志,代理服务器记录
- 直接暴露token风险更高
所以更安全的做法是:
前端只拿到access_token,后端用code+client_secret去换access_token,这样不容易直接暴露给浏览器
并且后续也不返回给前端,保存到后端的数据库或者缓存中,从前端拿到登录状态,后端来负责调用,就像调用大模型,一般也是后端来构造请求调用官方api的
5.2 OIDC
OIDC:OpenID Connect
建立在OAuth2.0上
OAuth 2.0关注的是我能不能访问你的资源
OIDC解决的是第三方应用怎么确认当前用户是谁
所以OIDC在OAuth 2.0基础上加了一个id_token
虽然Access_token一般来说每个用户也都是不一样的,但是Access Token 是给 Resource Server 看的,不是给 Client 当身份证看的
在 OAuth 2.0 里:
access_token 的主要接收者:Resource Server
用途:访问 API 资源
比如:
GET /user/repos
Authorization: Bearer <access_token>
GitHub API 看到这个 token 后会判断:
这个 token 是否有效?
有没有 read:user 权限?
能不能读取这个用户的数据?
它回答的是:
这个应用能不能代表用户访问某些资源?
而不是:
这个用户的标准身份信息是什么?
并且Access_token一般不像JWT一样可以解码,第三方应用拿到后根本不能解出user_id等信息
5.2.1 id_token
id_token通常是一个JWT,在里面会包含用户身份声明,如
{
  "sub": "123456789",
  "name": "SMR",
  "email": "xxx@example.com",
  "iss": "https://accounts.google.com",
  "aud": "your-client-id",
  "exp": 1715000000
}
这里比较重要的几个字段:
sub:用户在身份提供方那里的唯一 ID
iss:谁签发的这个 token
aud:这个 token 是发给哪个应用的
exp:过期时间
六.总结
回到最开始的问题:“服务器凭什么相信这个请求?” 答案无非是一步步加上去的证据链条——token 证明你是谁,签名证明请求没被改,时间戳和 nonce 证明这不是旧请求,OAuth 2.0 则让你在不交出密码的前提下把资源授权给第三方,而 OIDC 终于让第三方能确定“你到底是谁”。每一环都在填补 HTTP 天然不可信的坑。
永远记住几个关键点:
- 不要把token裸露在前端日志
- JWT不放敏感数据
- 签名校验不在前端完成
- 过期时间越短越好