一.什么是skills
1.1 为什么需要skills
在没有 Skills 之前,处理复杂任务(如营销活动分析)通常面临以下痛点:
- 重复劳动:每次都需要复制粘贴冗长的 Prompt。
- 上下文污染:所有背景资料(如 benchmarks、规则文档)一次性塞入上下文,消耗 Token 且容易干扰模型。
- 依赖个人经验:流程难以在团队间标准化复制。
peter steinberger在2026年5月9号12点38分曾经说过
The more skills you give codex,the less you have to prompt.
你给越多的技能你要给你的agent的提示词就越少,但并不是说你能够做甩手掌柜了,karpathy说
You can outsource your thinking, but you can’t outsource your understanding.
你不能把你的理解完全外包给AI,关键节点的判断还是需要人来决策的
所以准确来说skills就是把一整套流程甚至是工具包全部打包,它可以包含prompt,subagent,mcp,工具脚本,让agent根据用户意图自动调用
二.Skills的技术架构与文件结构
2.1 标准的skills结构
一个标准的 Skill 是一个文件夹,结构如下:
analyzing-marketing-campaign/  (技能根目录)
├── SKILL.md                   (核心入口文件)
└── references/                (引用的资源文件夹)
    ├── budget_reallocation_rules.md
    ├── data_quality_checklist.txt
    └── scripts/               (可选:Python/Bash 脚本)
2.2 SKILL.md
SKILL.md是技能的说明书,必须包含yaml头和Markdown指令,尤其是yaml头中的各种元数据,其中name和description是必填字段,最重要的还是description,不应该只写这个skill是什么,还要写什么时候使用,它才是skills自动触发的关键
---
name: analyzing-marketing-campaign # 必填:技能名称 (小写,短横线连接)
description: Analyzes weekly marketing campaign data... # 必填:用于触发技能的描述
inputs:
	- file: Excel/CSV,...
outputs:
	- markdown/Excel,...
---
# Instructions1. Read the input CSV data...(任务流程)
2. Perform Data Quality Check...
3. If user asks about budget, reference: references/budget_reallocation_rules.md
...
一个好的description通常包含三部分:
- 能力范围:这个 Skill 能做什么。
- 触发场景:用户说什么/上传什么时应该用。
- 边界条件:什么时候不要用,或者需要先询问什么。
2.3 渐进式披露
skills的核心就是渐进式披露,也是区别于长context的关键所在
- 初始状态:Context 中只有 name 和 description。
- 触发状态:用户意图匹配描述 -> 加载 SKILL.md。
- 执行状态:根据指令需求,按需加载 references/ 中的文件或执行脚本。
- 优势:极大节省 Token,降低模型“幻觉”,提高响应速度。
其实我之前一直不知道渐进式披露到底是如何实现的,一开始我以为是根据文件结构,AI模型只能看见最外层的文件夹名称…
不得不说有点肤浅了,并且完全不是这样,达咩
skills的核心是渐进式披露,至于为什么能够渐进式披露,其实这并不是AI本身的能力,是vibe coding工具或者agent工具自身主动探测skills,而不是模型凭空就能知道文件系统中有什么
以A社的claude code为例,官方的流程大致是这样
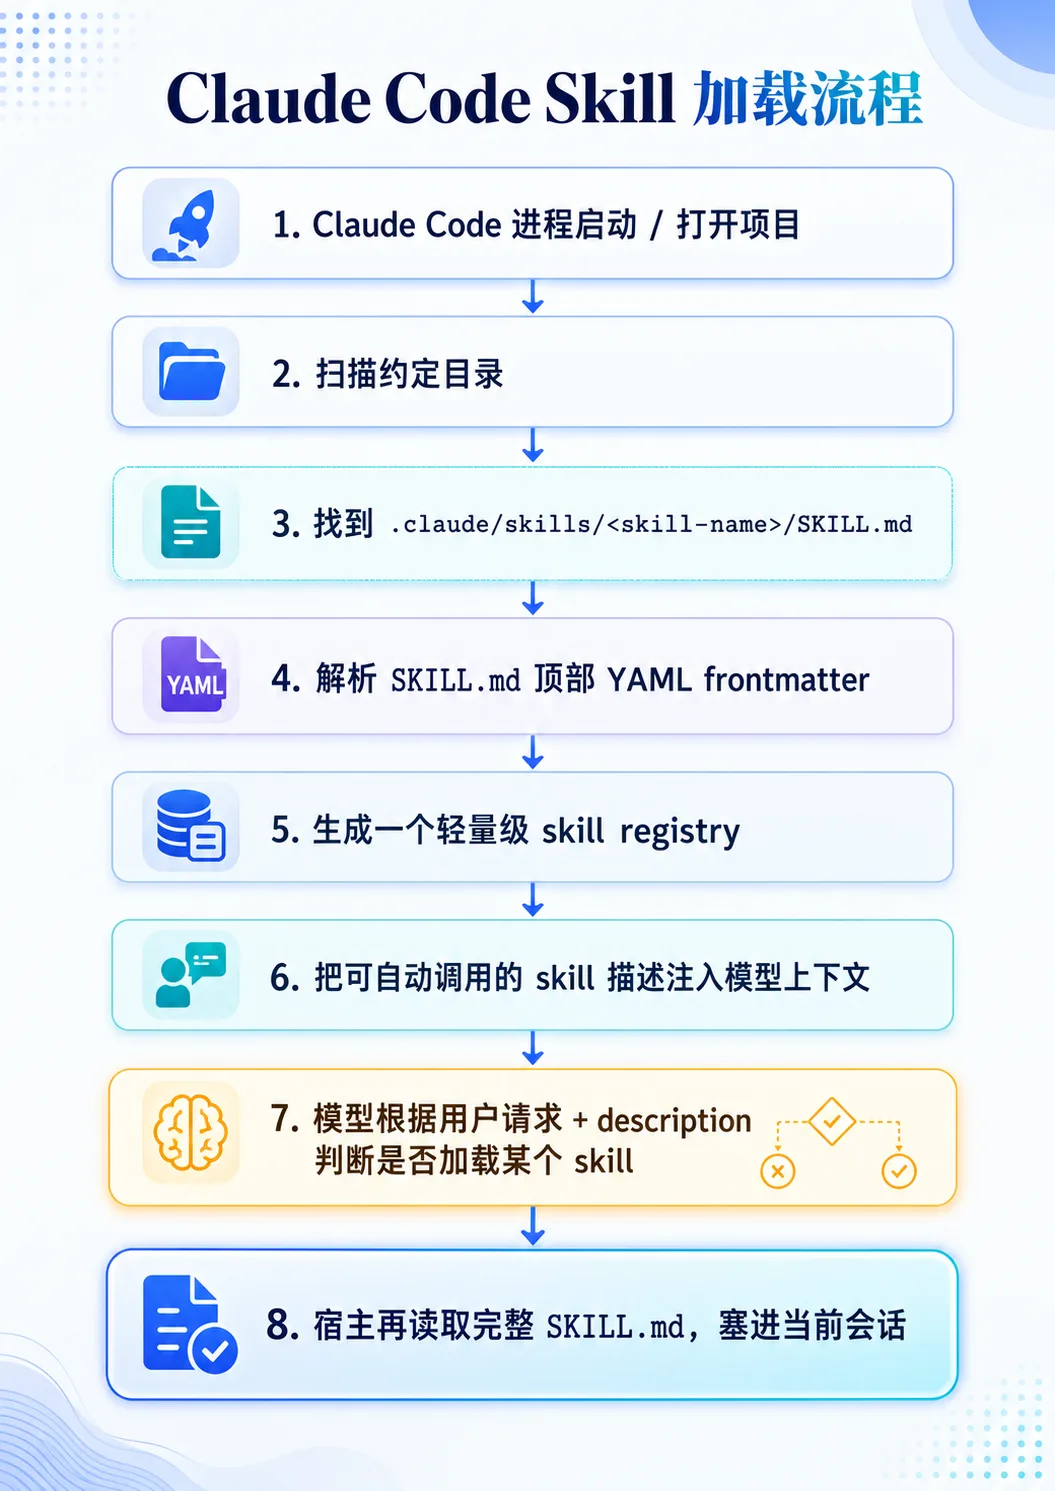
并且skill 可以放在个人、项目、插件、企业等位置,例如个人目录 ~/.claude/skills//SKILL.md,项目目录 .claude/skills//SKILL.md;并且它会监听这些 skill 目录的变化,新增、修改、删除可以在当前 session 生效。
这里的探测底层的代码大概是类似这样的:
// 定义所有可能存放 Skill 的目录来源
// 包括用户级、项目级、插件级、企业级等不同层级
const skillDirs = [
  "~/.claude/skills",                  // 用户个人全局 Skills 目录
  "<project>/.claude/skills",          // 当前项目内的 Skills 目录
  "<plugin>/skills",                   // 某个插件自带的 Skills 目录
  "<enterprise-managed-skills>",       // 企业统一管理的 Skills 目录
]

// 遍历每一个 Skill 来源目录
for (const dir of skillDirs) {
  // 遍历该目录下的每一个子目录
  // 通常每个子目录代表一个独立的 Skill
  for (const child of listDirectories(dir)) {
    // 拼出当前 Skill 的标准入口文件路径
    // Anthropic Skill 通常约定入口文件名为 SKILL.md
    const skillFile = path.join(child, "SKILL.md")

    // 判断这个 Skill 入口文件是否存在
    // 如果不存在,说明这个子目录不是一个有效 Skill
    if (exists(skillFile)) {
      // 读取 SKILL.md 的完整内容
      const raw = readFile(skillFile)

      // 解析 Markdown 文件顶部的 YAML frontmatter
      // frontmatter 是元数据部分,比如 name、description、allowed-tools 等
      // body 是正文部分,也就是真正的 Skill 指令说明
      const { frontmatter, body } = parseMarkdownWithYaml(raw)

      // 把解析出来的 Skill 信息注册到 registry 中
      // registry 可以理解成“技能注册表”或“技能索引”
      registry.push({
        // Skill 名称:
        // 优先使用 frontmatter 中声明的 name
        // 如果没有写 name,则退回使用目录名作为 Skill 名称
        name: frontmatter.name ?? basename(child),

        // Skill 描述:
        // 优先使用 frontmatter 中声明的 description
        // 如果没有写 description,则退回使用正文第一段作为描述
        // 这个 description 通常用于让模型判断什么时候应该调用该 Skill
        description: frontmatter.description ?? firstParagraph(body),

        // 保存 SKILL.md 的真实路径
        // 后续模型判断命中该 Skill 后,宿主可以根据这个路径加载完整正文
        path: skillFile,

        // 是否允许模型自动调用该 Skill:
        // 如果 frontmatter 中显式写了 disable-model-invocation: true,
        // 则表示不允许自动调用;
        // 否则默认允许自动调用
        autoInvocable: frontmatter["disable-model-invocation"] !== true,
      })
    }
  }
}
真正填充进提示词的只是那些元数据,大概像下面这样
Available skills:
- frontend-design: Create distinctive production-grade frontend interfaces...
- pdf-processing: Extract text and tables from PDF files...
- summarize-changes: Summarizes uncommitted changes and flags risky edits...
然后模型再根据需要去请求加载完整的skills
大概就是这样的三层递进
Anthropic官方把它拆成三层:Level 1 是 metadata,启动时总是加载;Level 2 是SKILL.md正文,命中任务后加载;Level 3是资源文件和脚本,只在需要时读取或执行。
还有补充一个点,很多时候并不需要你来把整个skills写出来,你只需要跟你的agent描述好你的需求,步骤,它就能够帮你把需要的skills做出来,甚至你还可以把看到的一篇文章,一个思维方式让大模型总结成skills