如果要给AI在某些专业的领域变得更强,一般有几种方法
1.直接训练微调模型,这个工作量和需要的算力比较大,毕竟是涉及到模型内部的参数
2.RAG
3.目前最新的一个解决方案,GitHub项目 supermemory。它是包括了RAG,但是不止于RAG,它相当于给了AI一个非常完整的上下文环境,并且还把信息用graph memory的方式进行存储
这里主要是介绍下RAG以及对RAG的优化。
首先RAG,全称Retrieval-Augmented Generation,检索增强生成。
最简单的理解是把用户的输入转化为向量,然后与向量数据库如ChromaDB或者Qdrant中的文本向量进行匹配,向量是类似于(x1,x2,x3….)这种形式的,向量的距离有的时候会用常见的欧式距离,如下面的公式,但更多的是余弦相似度和点积的方式运算。
就是三维向量距离公式向n维的推广,距离越近,则表示语义越相关,然后根据距离从小到大进行排序,选出top N条。
但如果更细一点理解呢,为什么是变成向量呢?
首先一段文本,如输入what’s your name,会被分词器tokenizer切成一个个token,然后每个token又会变成一个token id,如:
what's -> 30

your -> 70

name -> 65
但这里的token id,它其实只是一个索引罢了。
比如your这里对应的token id是70,表示的是去embedding表中取第70行向量
其中V指的是vocabulary size,即词表大小,可以理解成这个embedding表有多少个token,即多少行
D的话是指的是向量维度,即对应的向量有多少个数字
上面your对应的token_id为70,那么就是找第70行的向量,以此类推,所以本质上token\_id就是一个索引罢了。
经过查表这个过程得到初始向量,但还需要经过一些数学运算,才能变成带有上下文attention的向量
不过如果只靠token_id查表的话,其实模型本身是不知道token之间的顺序的,所以如果没有位置标记,自来水和水来自对模型来说就是完全一样的输入,所以就有了另一个东西position\_id。
即位置编码
所以第i个位置的token向量,更接近于token向量+位置向量
这里的i表示的是第几个向量,即向量位置
在经过Transformer编码得到上下文化的token表示:
(这里的每个h是第i个词在整个语境中的表示)
最后是要经过Pooling,Pooling相当于是聚合的意思,把很多个token向量压缩成一个整体向量,最简单的Pooling方法是Mean Pooling,即对所有的token向量求平均。
当然现在大模型一般用的都是更高级点的方法,通过这样的方式我们就得到了,即query的向量表示。
通过类似的方式,我们也能得到文本chunk的向量表示,然后进行向量的距离运算。
那这是一般的RAG,但是如何对RAG进行优化呢?
A社,Anthropic 就在他们的博客文章 Introducing Contextual Retrieval 中提出了一个概念,Contextual Retrieval,即上下文检索,这篇文章主要就是讲述的这种优化方式。
想要知道如何优化就先要知道RAG的不足,比如RAG虽然能进行语义上的理解,但很难把握住一些精准的字符串,如错误码TS-999这种,或者类名,表名,API路径是啥,这些需要精确命中的东西。
先介绍一个算法TF-IDF
TF:Term Frequency,词频,指的是某个词在某篇chunk出现的越多,越重要
IDF:Inverse Document Frequency,逆文档频率,这个相当于是反过来,在这个chunk里常见,但在全文档中更少见的词,更有价值
而BM25则是这个算法的改进
对于一个query q和一个chunk D,BM25经常写成如下的公式:
表示的是query里的每个词
-
q:query,用户查询
-
D:某个文档或某个 chunk
-
t:query 里的某个词
-
f(t,D):词 ttt 在文档 DDD 里出现了几次
-
∣D∣:文档 D的长度
-
avgdl:整个语料库中文档平均长度
-
k1和b:两个超参数,是事先人为设计好的
首先这里的求和,不是对IDF(t)进行的求和,而是对后面整体进行的求和,而后面的整体是词t对文档D的得分,这些词对当前chunk各加多少分,最后求和,通过这个可以知道命中的词越多,当前chunk的分数就越高。
这里的IDF(t)逆文档频率相当于词本身有多值钱,后面的分式则是这个词在当前文档中的匹配强度
词项得分=词的重要性×这个词在当前文档里的匹配强度
一.IDF(t)
衡量这个词在语料库中稀有不稀有
比如:
-
“the”“is”“系统”“问题” 这种词,到处都有,IDF 低
-
“TS-999”“PostgreSQL”“LoRA” 这种词,更稀有,IDF 高
IDF的常见形式是:
-
N:语料库总文档数
-
nt:包含词 t 的文档数
如果nt很大,说明这个词很多文档都有,那IDF小
如果nt很小,说明这个词很稀有,那IDF大
二.分式项
2.1 f(t,D)词频
表示词t在文档D中的出现频率
如某个query词是Z
在某个chunk中出现了3次
那么f(z,D) = 3
但实际上这里的词频不是线性增长的,有一个饱和机制,词频越大,分数仍然增加,但越来越慢
2.2 看整个分子f(t,D)()
这里的确是直接相乘,但如果等等看分母就知道了,k1这里相当于是调节饱和曲线的参数,通常在1.2到2.0左右
2.3 看分母
它的作用是让词频不至于无限膨胀,并且考虑文档长度
第一块f(t,D)随着分子分母都增大,最后增长会慢下来
第二块:
|D|:当前chunk长度
avgdl:文档的平均chunk长度
如果比值>1,说明chunk偏长
这里是为了防止长篇的chunk天然占便宜的因素,相当于做了下长度归一化,去除文档长度的影响
b:
这里的b一般取0.75
当b=0时,那么这里就是1,那么就完全不考虑文档长度
如果b=1,那么长度影响就会被完全打开
如果b=0.75,那就相当于是一种折中
k1:
k1控制的是词频增加时分数的增长,如果k1大,那么很快就会出现饱和,毕竟是分母
最后BM25的本质可以压缩为:一个chunk的得分 = query 中每个词的重要性 × 它在chunk中的匹配强度,再把这些贡献加总;其中匹配强度会考虑词频饱和和文档长度归一化。
最后按照分数进行排序,按分数取出最高的top K
第一步优化:
通过standard RAG和BM25,分别根据分数排序选出top N和top K个向量填充给大模型的system prompt,相当于做了一些信息的补充
第二步优化:
这里首先介绍一个概念:prompt cache,提示词缓存,意思就是相同或重叠的prompt前缀,如system prompt,可以复用之前已经计算过的前缀处理结果,也就是复用前缀结果之前计算出来的中间状态,像deepseek是默认开启提示词缓存的,不过有些需要在代码中手动开启。
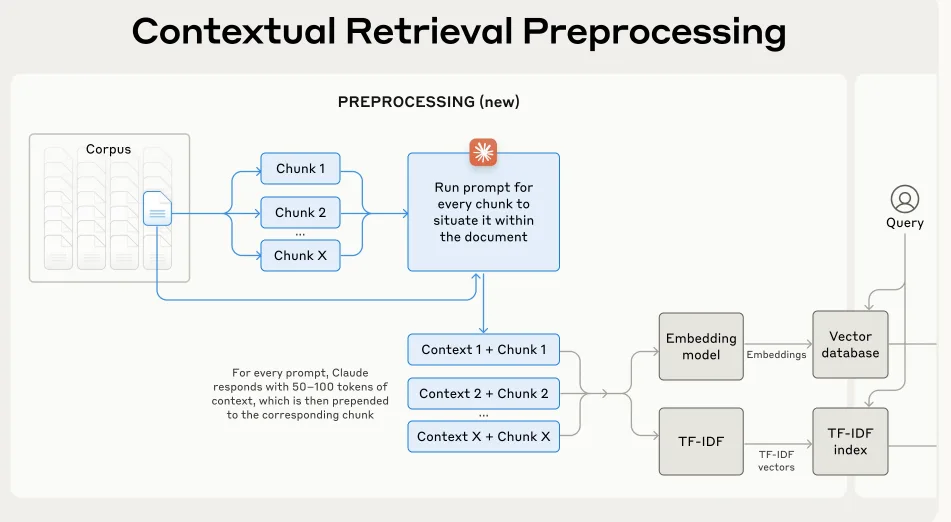
这里的优化就算对事先拆分出来的每一个片段,添加一段基于上下文的信息,不然chunk与chunk之间的信息是破碎的,比如想查询某个公司在第三季度的盈利,却匹配到了公司的盈利,第三季度还在别的chunk中。
思路是给一个优化的prompt给大模型,包含当前片段和整个文档内容,因为有prompt cache,所以会减少很多的token消耗,不然每次都塞入整个文档还是太费token了
这里Anthropic给出的官方的prompt内容为:
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.
然后把加入了上下文信息的chunk进行BM25的索引,后续的向量化并存入向量数据库以供后续的查询
第三步优化:
第三步优化我们是通过rerank model来进行,什么是rerank
rerank是对召回的所有结果,进行一次精细的排序。
前面虽然RAG和BM25已经进行过一次排序了,一个是按向量相似度,一个是按照词面匹配
而rerank的话则把query和每个chunk放在一起,逐个重新判断,rerank需要进行语义的理解,所以需要一个rerank model做精细判断
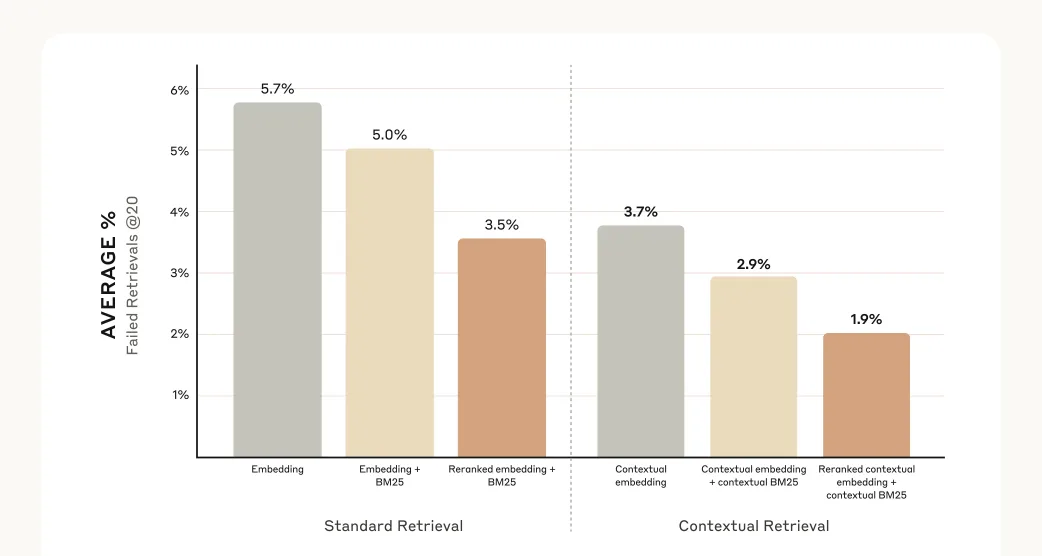
经过这三步的优化,RAG的查询失败率可以减少67%(5.7% -> 1.9%,数据来自上文 Anthropic 原文的评估)